Rapport Couverture Search Console : lire, prioriser, corriger les erreurs
Sur cette page
Le rapport Couverture de Google Search Console (appelé aussi rapport Indexation des pages) est l’outil de diagnostic le plus concret pour comprendre pourquoi une URL n’apparaît pas dans les résultats. Le sujet Google Search Console couverture erreurs revient constamment parce que la lecture du rapport est contre-intuitive : cinq états mélangent des vraies pannes techniques, des choix éditoriaux volontaires, et des décisions unilatérales du moteur. La priorité de correction dépend de laquelle des trois familles s’applique. Cet article détaille les cinq états, la logique de tri, et le workflow de debug avant toute demande de réinspection.
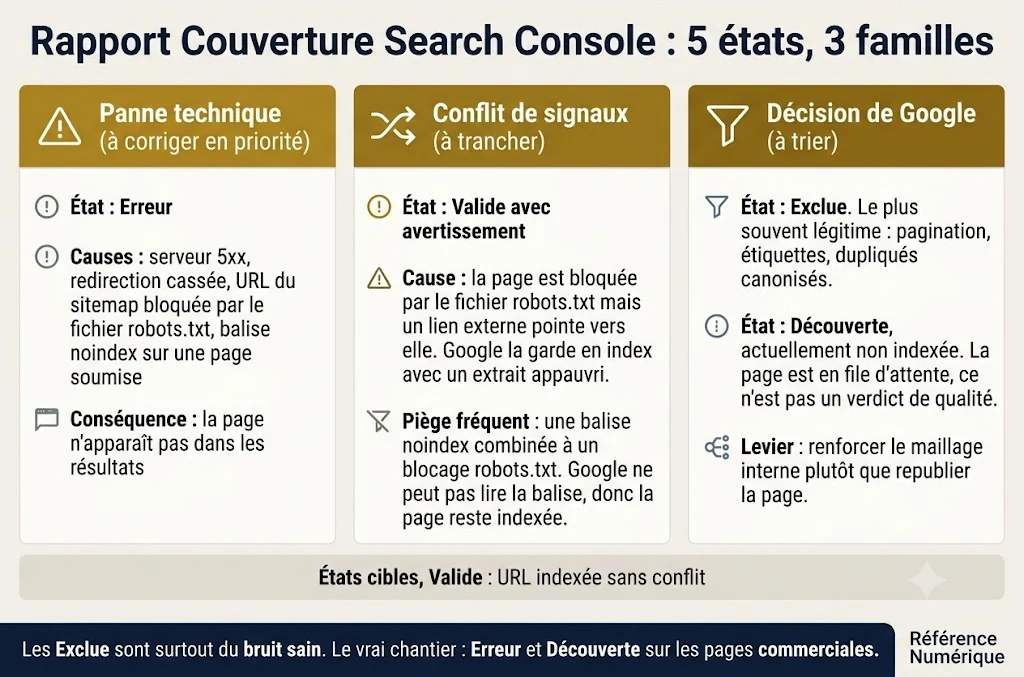
Les 5 états du rapport Couverture
L’interface classe chaque URL connue de Google dans l’un des cinq états suivants.
Erreur. Google a tenté d’indexer la page et l’opération a échoué pour une raison bloquante : serveur 5xx, redirection cassée, URL renvoyée par le sitemap mais bloquée par robots.txt, ou balise noindex sur une page pourtant soumise. Ces URL n’apparaissent pas dans les résultats, période.
Valide avec avertissement. La page est indexée mais Google signale un conflit : typiquement, elle est bloquée par robots.txt alors qu’un lien externe pointe vers elle. Google la garde en index par précaution mais avec un snippet appauvri.
Valide. L’URL est indexée sans conflit. C’est l’état cible.
Exclue. Google a décidé de ne pas indexer la page, sans que ce soit une erreur : noindex volontaire, dupliqué avec ou sans canonique, page redirigée, page non trouvée (404) qui a fini par sortir de l’index. La majorité des Exclue sont éditoriales et souhaitées.
Découverte, actuellement non indexée. Google connaît l’URL (souvent via le sitemap ou un lien interne) mais ne l’a pas encore explorée ou choisit de ne pas la traiter maintenant. Cet état est le plus frustrant : rien ne bloque techniquement, le moteur a simplement mis la page en file d’attente.
Comment prioriser les fixes selon l’impact business
L’erreur classique : ouvrir le rapport et attaquer la liste dans l’ordre d’affichage. La bonne logique se fait sur trois axes.
Axe 1 : est-ce qu’il s’agit d’une URL qui devrait générer du trafic? Une catégorie WooCommerce vide, un tag WordPress résiduel, une pagination profonde peuvent tous produire des Exclue légitimes. Aucune correction requise. À l’inverse, une page service principale en Découverte non indexée bloque directement le revenu.
Axe 2 : est-ce que la cause est systémique? Trois URL en Soft 404 sur des fiches produit similaires suggèrent un template avec du contenu trop mince. Une correction sur le template résout les trois d’un coup, plus toutes les prochaines fiches créées. Un fix ponctuel manque le vrai problème.
Axe 3 : quelle est la fréquence de re-crawl? Google explore les URL avec des cadences très différentes. Une correction sur un article publié il y a trois ans peut prendre des semaines à être re-crawlée sans demande explicite ; une page très visitée peut se corriger en 48 heures.
Ordre pratique : d’abord les Erreurs sur URL commerciales importantes, ensuite les Exclue qui devraient être Valides (canoniques mal posées, redirections en boucle), enfin les Découverte non indexées après avoir vérifié que le contenu justifie l’indexation.
Workflow de debug pour une URL bloquée
Avant de cliquer sur « Demander une indexation », le workflow suivant identifie la cause racine et évite les allers-retours.
Étape 1 : URL Inspection dans Search Console. L’outil retourne l’état canonique choisi par Google, la date du dernier crawl, la version indexée, et les raisons d’exclusion. C’est le point d’entrée obligatoire.
Étape 2 : test en direct. Le bouton « Tester l’URL en direct » simule un crawl immédiat. Compare la version indexée à la version live : si les deux diffèrent (par exemple noindex en live, absent lors du dernier crawl), l’origine du blocage devient claire.
Étape 3 : vérification des directives. Ouvrir la page en navigation privée et inspecter le <head> : présence de <meta name="robots" content="noindex">, canonique pointant ailleurs, X-Robots-Tag dans les en-têtes HTTP. Vérifier aussi robots.txt pour la même URL.
Étape 4 : contenu et signaux qualité. Sur un Soft 404, la page renvoie un statut 200 mais Google la juge sans contenu utile : template quasi vide, message d’erreur applicatif, page de tri sans produits. Corriger le contenu ou renvoyer un vrai 404 selon le cas.
Étape 5 : réinspection demandée seulement après correction confirmée. Le quota de demandes est limité et le crédit s’épuise vite si les fixes ne sont pas concluants. Ne jamais réinspecter par réflexe.
Pour un audit régulier de ces signaux, une checklist d’audit SEO documente les autres points de vérification à intégrer dans la même passe. La compréhension du fonctionnement général de l’outil est détaillée dans notre article de fond sur Google Search Console, et l’articulation avec l’accessibilité technique (qui influence l’indexation) est reprise dans les bases WCAG pour le web.
Trois pièges récurrents à connaître
Piège 1 : la case Exclue traitée comme un problème. Les Exclue légitimes (paginations, filtres, tags, dupliqués canonisés) sont souvent la majorité du volume. Les vider par des redirections agressives fragilise la structure interne du site sans améliorer le trafic. Un audit Exclue commence par un tri : légitimes vs à corriger.
Piège 2 : Découverte non indexée interprétée comme un signal de basse qualité. Ce n’est pas mécaniquement le cas. Sur un site jeune ou peu autoritaire, Google prioritise sévèrement ce qu’il explore. Renforcer le maillage interne vers les URL en attente et améliorer les signaux d’autorité (dont les liens externes) sont plus efficaces que republier la même page.
Piège 3 : noindex combiné à un blocage robots.txt. Si robots.txt bloque l’URL, Google ne peut pas lire la balise noindex. Résultat : la page reste indexée avec un snippet minimal. Pour la sortir vraiment de l’index, débloquer robots.txt, laisser Google recrawler, puis (si voulu) rebloquer une fois l’URL retirée.
Ce qui doit ressortir de l’exercice
Le rapport Couverture n’est pas une liste de tâches à zéroter. C’est un diagnostic à interpréter en fonction de la valeur business de chaque URL et de la nature du blocage. Les états Erreur et Découverte non indexée sur pages commerciales sont prioritaires. Les Exclue sont majoritairement du bruit sain. Une passe mensuelle disciplinée sur ce rapport prévient l’accumulation silencieuse de pertes de trafic. Pour intégrer la démarche dans une architecture éditoriale plus large, l’organisation par cocon sémantique réduit mécaniquement le nombre d’URL orphelines en attente d’indexation.
Sources
- Google Search Central : documentation officielle de résolution des problèmes Search Console (couverture, indexation, exploration), consultée le 2026-07-04.
- Google Search Console Help : documentation d’interprétation du rapport Couverture (les 5 états, motifs d’exclusion, workflow de correction), consultée le 2026-07-04.
- Ahrefs Blog : guide industry standard sur l’utilisation de Search Console pour le diagnostic d’indexation, consulté le 2026-07-04.